Loi 25 et IA générative : vos prompts sont aussi des données
Un prompt peut contenir des renseignements personnels, créer des inférences et déclencher de nouvelles obligations de gouvernance. Ce que les dirigeants québécois doivent comprendre avant de connecter l’IA aux données de l’entreprise.
Une entreprise peut protéger soigneusement son CRM, son ERP et ses serveurs, puis laisser un employé copier dans une IA générative le courriel complet d’un client, un dossier de candidature ou un tableau contenant des informations financières.
Le problème n’est pas le prompt en soi. C’est ce qu’il contient, ce qu’il devient et ce qui lui arrive ensuite.
Au Québec, un renseignement personnel est une information qui permet d’identifier directement ou indirectement une personne. La Commission d’accès à l’information précise maintenant que les renseignements générés par un système d’intelligence artificielle ou inférés à propos d’une personne peuvent eux aussi être des renseignements personnels assujettis aux lois applicables.
Source : Commission d’accès à l’information — Qu’est-ce qu’un renseignement personnel?
L’arrivée de l’IA générative ne crée donc pas un espace juridique parallèle. Elle ajoute plutôt de nouvelles façons de collecter, d’utiliser, de communiquer et de créer des renseignements personnels.
Un prompt peut contenir beaucoup plus qu’une question
Prenons un exemple banal.
Une employée reçoit une plainte d’un client. Pour gagner du temps, elle demande à un outil d’IA de rédiger une réponse plus professionnelle. Elle copie le courriel original, qui contient le nom du client, son numéro de commande, son adresse, quelques détails sur sa situation et l’historique du problème.
Pour l’employée, elle vient simplement de demander de l’aide pour rédiger un courriel.
Du point de vue des données, plusieurs opérations peuvent pourtant avoir eu lieu : des renseignements personnels ont été transmis à un système; ils ont potentiellement été journalisés; une réponse a été générée à partir de ceux-ci; des données dérivées ou des inférences ont peut-être été créées; et le fournisseur peut appliquer ses propres règles de conservation ou d’utilisation.
C’est pourquoi la première question d’une entreprise ne devrait plus simplement être : « Avons-nous le droit d’utiliser cet outil? »
Elle devrait aussi demander : quelles données lui permettons-nous de recevoir, pour quelle raison et qu’arrive-t-il à ces données après la réponse?
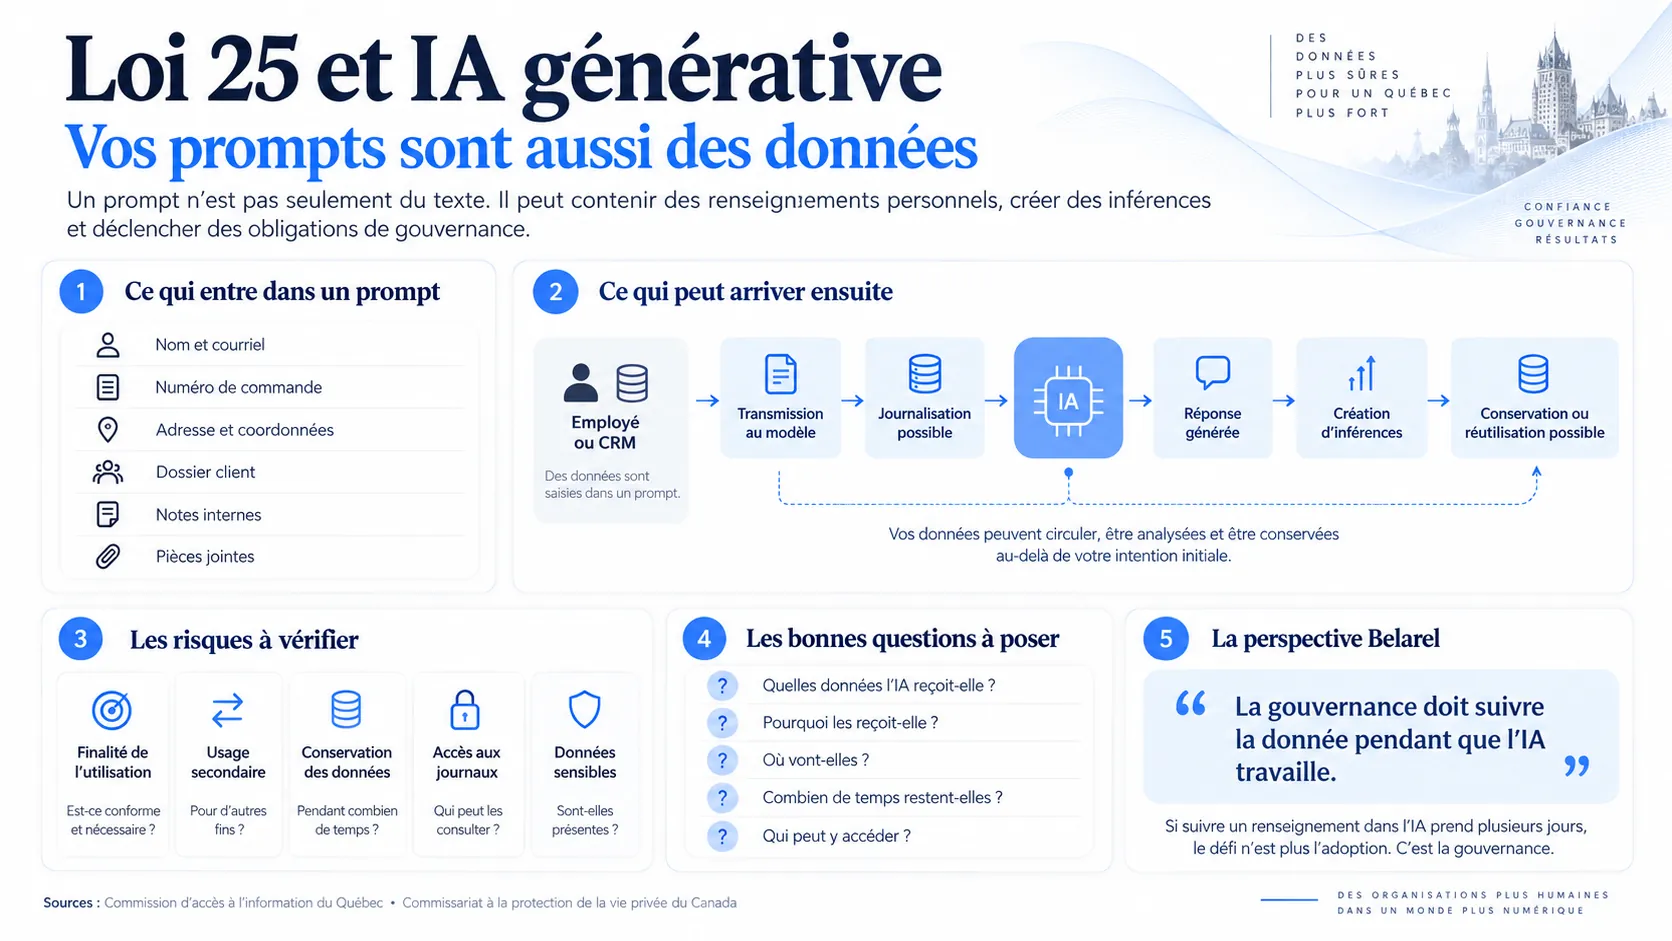
Vue d’ensemble : ce qui peut entrer dans un prompt, ce qui peut arriver ensuite aux données et les questions de gouvernance à poser.
L’enquête de la CAI sur l’IA générative change la discussion
Le 6 mai 2026, la Commission d’accès à l’information a publié avec d’autres autorités canadiennes les résultats de son enquête sur OpenAI et ChatGPT. L’enquête portait notamment sur la collecte, l’utilisation et la communication de renseignements personnels pour entraîner et déployer un système d’IA générative.
Les autorités ont relevé des enjeux touchant la collecte excessive, le consentement, la transparence, l’exactitude des renseignements, leur accès, leur correction, leur conservation et la responsabilité organisationnelle. Pour le Québec, la CAI a conclu qu’OpenAI n’avait pas pleinement respecté les obligations décrites dans le rapport.
Source : CAI — Résultats de l’enquête conjointe sur OpenAI et ChatGPT
La décision est particulièrement instructive pour les entreprises parce que la CAI ne s’est pas limitée à la sécurité informatique.
Elle s’est intéressée à l’utilisation secondaire des conversations.
La CAI a notamment recommandé que l’utilisation des clavardages pour l’entraînement soit désactivée par défaut, que les utilisateurs soient informés lorsque leurs conversations peuvent servir à l’entraînement et que la conservation historique des renseignements soit expliquée ou, à défaut, que ceux-ci soient détruits ou anonymisés.
Ce n’est pas une règle universelle disant que toute entreprise doit automatiquement désactiver tout entraînement dans toute situation. C’est néanmoins un signal réglementaire très clair : la finalité secondaire d’une donnée et les paramètres par défaut comptent.
Le véritable problème est souvent invisible
Lorsqu’une entreprise collecte un renseignement personnel pour traiter une commande, gérer un employé ou répondre à un client, elle dispose d’une finalité déterminée.
Introduire ensuite ce renseignement dans un autre système pour une nouvelle utilisation peut soulever une question différente.
La CAI rappelle qu’en principe, les renseignements personnels sont utilisés pour les objectifs déterminés lors de leur collecte et que leur réutilisation pour d’autres objectifs doit être évaluée selon les règles de nécessité, de consentement et les exceptions prévues par la Loi.
Source : CAI — Utilisation et communication des renseignements personnels
Cela devient particulièrement important lorsqu’un fournisseur pourrait utiliser les interactions pour améliorer un service, entraîner un modèle, effectuer des analyses ou conserver un historique.
Un prompt n’est donc pas seulement du texte. C’est potentiellement une transaction de données.
L’entreprise doit connaître le chemin de l’information
Imaginons maintenant un assistant IA relié au CRM.
L’utilisateur demande : « Résume-moi le dossier de ce client et prépare la réponse. »
Le système consulte le CRM, récupère plusieurs informations, les fournit au modèle, produit une réponse et enregistre peut-être la conversation.
Pour gouverner correctement ce processus, il faut pouvoir répondre à des questions beaucoup plus précises que « notre IA est-elle sécurisée? »
Il faut connaître les renseignements auxquels elle a accès, les modèles auxquels ils peuvent être transmis, les fins autorisées, les durées de conservation, les personnes pouvant consulter les journaux et les utilisations secondaires permises.
Les autorités canadiennes de protection de la vie privée recommandent d’ailleurs aux organisations utilisant l’IA générative d’établir des calendriers de conservation pour les renseignements contenus dans les requêtes et les résultats, d’utiliser lorsque possible des données anonymisées ou dépersonnalisées et de ne fournir des renseignements sensibles dans un prompt que lorsque cela est autorisé. Elles indiquent également que, sauf indication contraire, les requêtes ne devraient pas être conservées pour des finalités secondaires ou communiquées.
La perspective Belarel : gouverner la donnée au moment où l’IA travaille
Une politique interne disant « ne mettez pas de renseignements confidentiels dans l’IA » constitue un point de départ. Elle ne suffit plus lorsque l’IA commence à être intégrée directement aux opérations.
Lorsque les systèmes peuvent eux-mêmes consulter des dossiers clients, des courriels ou des documents, la gouvernance doit devenir exécutable : quelle donnée peut être utilisée, par quel agent, avec quel modèle, pour quelle tâche et sous quelles conditions?
L’enjeu ne consiste plus seulement à former l’utilisateur. Il consiste à encadrer techniquement ce que l’IA peut faire avec l’information qu’on lui confie.
Un dirigeant devrait aujourd’hui pouvoir demander : si je prends un renseignement personnel de notre CRM et que je suis son parcours à travers notre IA, savons-nous exactement où il va, pourquoi il y va, combien de temps il y reste et ce qui peut être fait avec lui?
Si la réponse exige plusieurs jours d’enquête, le défi n’est probablement plus l’adoption de l’IA. C’est sa gouvernance.