Vos données sont-elles vraiment prêtes pour les agents IA?
Avoir des données ne suffit pas. Pour être utiles à un agent IA, elles doivent être accessibles, autorisées, contextualisées et actionnables.
Votre entreprise a probablement déjà beaucoup de données.
Des clients dans le CRM. Des commandes et des prix dans l’ERP. Des demandes dans les courriels. Des procédures dans des documents. Des interventions dans un système de service. Des chiffres dans des feuilles de calcul.
Cela ne signifie pas pour autant qu’un agent IA peut les utiliser correctement.
Lorsqu’une IA se contente de répondre à une question, une mauvaise information peut produire une mauvaise réponse. Lorsqu’un agent peut ensuite modifier un dossier, répondre à un client, créer une commande ou déclencher une opération, la question devient beaucoup plus importante.
> Une donnée n’est pas prête pour un agent simplement parce qu’elle existe. Elle doit être disponible, accessible, autorisée, contextualisée et actionnable.
Ce sont cinq conditions très différentes.
Le problème commence avant même l’IA
Avant de demander si une IA peut utiliser les données de l’entreprise, il faut déjà savoir où elles se trouvent et ce qu’elles contiennent.
Cela semble évident. Dans la pratique, l’information sensible ou utile peut être dispersée entre des bases structurées, des dossiers partagés, des courriels, des conversations numériques, des dépôts de fichiers ou d’autres systèmes.
Dans ses lignes directrices 2026 sur la classification des données, le NIST souligne que les organisations doivent être capables de découvrir, identifier et classifier leurs données, notamment les données sensibles non structurées, afin de savoir ce qu’elles possèdent et de mieux contrôler leur utilisation.
Pour un agent IA, cette connaissance devient la première étape.
Un agent ne peut pas utiliser correctement une information que l’entreprise elle-même ne sait pas identifier.
Un agent ne travaille presque jamais avec une seule source
Prenons un exemple simple.
Un client écrit :
« Ma pièce est défectueuse. Est-elle encore sous garantie et pouvez-vous envoyer quelqu’un? »
Pour traiter cette demande, un agent pourrait devoir consulter :
- le CRM pour identifier le client;
- l’ERP pour vérifier le produit et la date d’achat;
- le système de service pour voir les interventions précédentes;
- un document pour connaître les conditions de garantie;
- le courriel actuel pour comprendre le problème.
La difficulté n’est donc pas seulement d’avoir les données.
Il faut pouvoir assembler les bonnes informations pour cette demande précise.
C’est précisément ce qui distingue de plus en plus un agent IA d’un outil qui analyse simplement un document isolé : l’agent peut devoir naviguer entre plusieurs ensembles de données, applications et outils pour accomplir une tâche.
Le NIST en a d’ailleurs fait un sujet spécifique en 2026. Dans son document de travail sur l’identité et l’autorisation des agents logiciels, il souligne que les bénéfices des agents passent par leur capacité à accéder à divers ensembles de données, outils et applications — et que cet accès exige en retour des mécanismes appropriés d’identification, d’autorisation et d’audit.
C’est ici que « données prêtes pour l’IA » prend un sens beaucoup plus large.
Cinq états d’une donnée réellement utilisable
1. Disponible
La donnée existe et l’entreprise sait qu’elle existe.
Elle peut être structurée dans un ERP ou cachée dans un PDF joint à un courriel vieux de trois ans.
Ce premier niveau paraît banal, mais il est fondamental : avant de parler d’IA, il faut savoir quelles informations existent, où elles résident et lesquelles sont sensibles.
2. Accessible
L’agent peut atteindre la source nécessaire.
C’est une question différente.
Une donnée peut être parfaitement propre, exacte et bien classifiée tout en restant enfermée dans un système auquel l’agent ne peut pas accéder.
L’entreprise doit donc distinguer :
« Nous possédons cette information »
de :
« Le système qui exécute cette tâche peut obtenir cette information lorsqu’il en a besoin. »
La connexion technique compte. Mais elle ne suffit pas.
3. Autorisée
L’agent a le droit d’accéder à cette information pour cette tâche.
C’est probablement le changement le plus important lorsqu’on passe d’une IA isolée à des agents connectés aux systèmes de l’entreprise.
Le document 2026 du NIST sur les agents met précisément l’accent sur cette question : comment identifier un agent, déterminer ce qu’il est autorisé à faire et conserver suffisamment de traces pour reconstruire ses actions.
Un agent chargé de fixer un rendez-vous peut avoir besoin du nom, du numéro de téléphone et des disponibilités d’un client.
Cela ne lui donne aucune raison de consulter son historique de crédit.
Connecter un agent à un système n’est pas lui donner carte blanche sur le système.
4. Contextualisée
Une donnée doit également avoir le bon sens dans la situation où elle est utilisée.
Un montant de 2 500 $ n’est pas une information suffisante.
Est-ce le solde du client? Sa limite de crédit? Une soumission? Le prix d’une pièce? Le seuil d’approbation d’un gestionnaire?
Même la réglementation européenne reflète cette importance du contexte. Pour les systèmes d’IA à haut risque relevant de l’article 10 de l’AI Act, les pratiques de gouvernance des données doivent notamment considérer leur origine, leur préparation, leur disponibilité, leur adéquation et le contexte spécifique dans lequel le système doit fonctionner. Ces exigences ont un champ juridique précis — elles ne s’appliquent pas automatiquement à chaque agent d’entreprise — mais elles illustrent un principe utile : la qualité d’une donnée dépend aussi de l’usage auquel elle est destinée.
Un agent doit donc comprendre davantage qu’une valeur.
Il doit comprendre ce que cette valeur représente dans ce processus.
5. Actionnable
C’est la dernière frontière.
L’information est disponible. L’agent peut y accéder. Il est autorisé à la consulter. Il comprend son contexte.
Que peut-il maintenant faire avec cette information?
Un agent peut être autorisé à voir une limite de crédit sans être autorisé à la modifier.
Il peut déterminer qu’un produit semble couvert par une garantie sans avoir le droit d’approuver automatiquement un remplacement de 15 000 $.
Il peut préparer une opération et devoir ensuite la soumettre à une personne autorisée.
Les travaux de l’OpenID Foundation sur l’autorisation à l’ère des agents illustrent justement cette distinction. Ses travaux AuthZEN prévoient des situations où une action ne peut pas encore être autorisée parce qu’une condition manque : approbation, consentement, autorité déléguée, justification ou évaluation du risque. La politique demeure celle qui décide si l’action peut finalement avoir lieu.
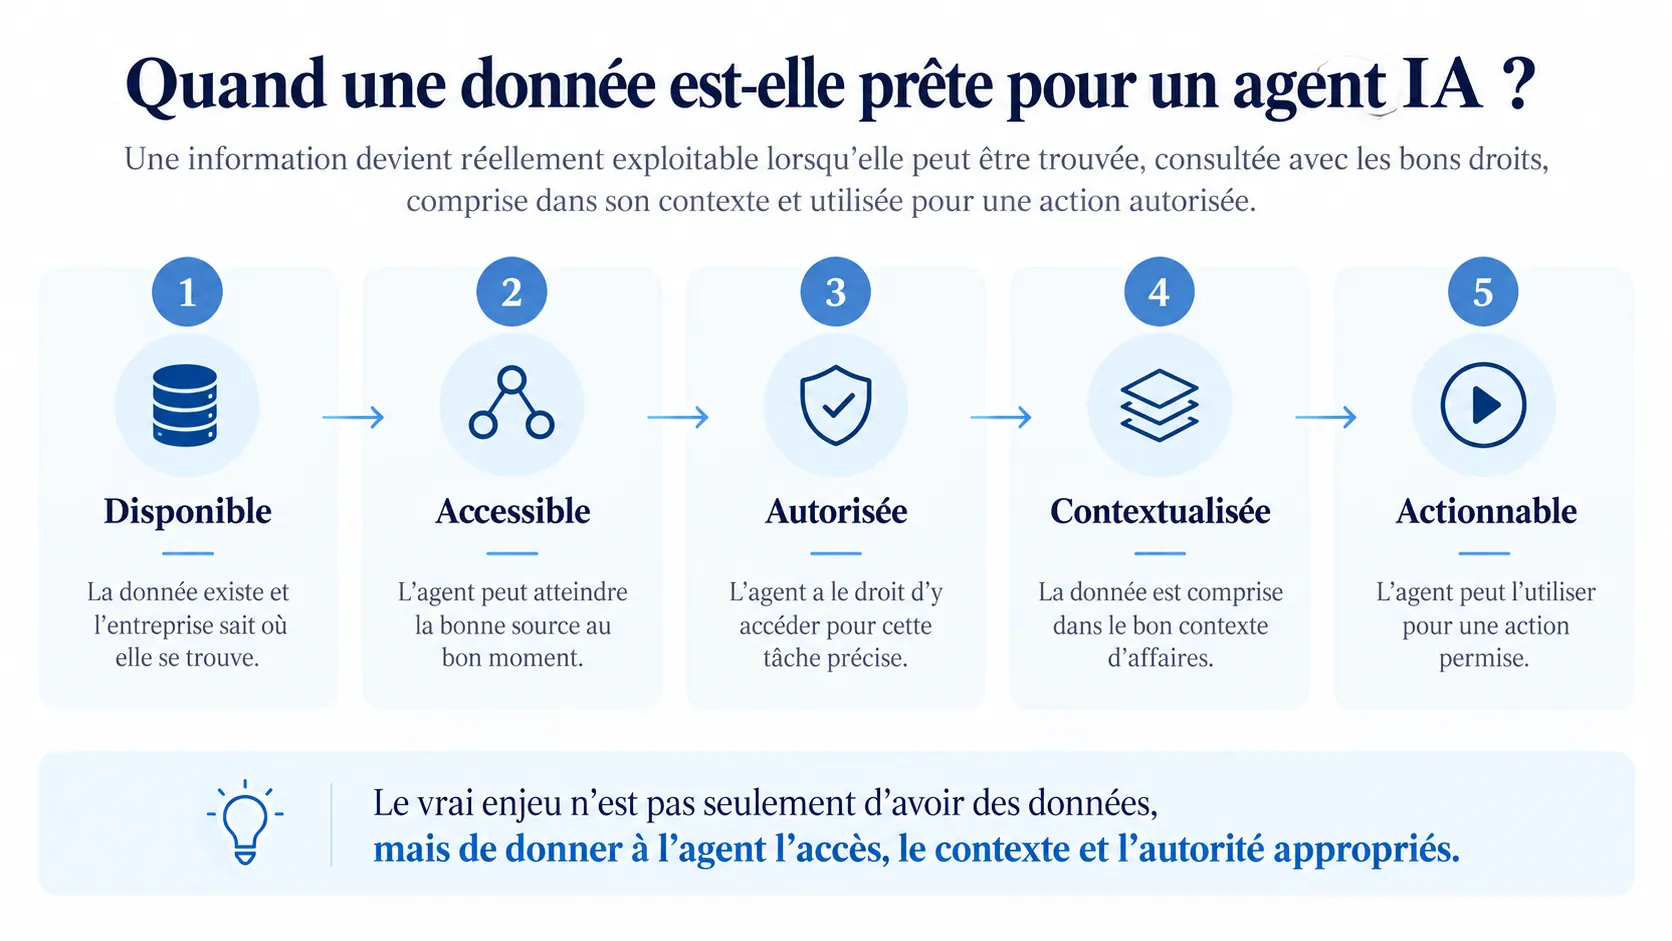
Une donnée devient réellement exploitable par un agent lorsqu’elle peut être trouvée, consultée avec les bons droits, comprise dans son contexte et utilisée pour une action autorisée.
Accès aux données et autorité d’action sont deux décisions différentes
Cette distinction est facile à manquer.
Pour rendre un agent plus utile, il peut être tentant de lui ouvrir davantage de systèmes et davantage de données.
Mais plus d’accès ne produit pas automatiquement un meilleur agent.
Cela produit surtout un agent qui peut voir davantage de choses.
La question suivante est de savoir lesquelles il devrait voir et ce qu’il peut en faire.
C’est pourquoi l’architecture des données et la gouvernance des agents finissent par se rejoindre.
On ne peut plus seulement définir des accès selon le rôle général d’une application. Il faut progressivement raisonner selon le contexte :
Quel agent? Pour quel objectif? Au nom de qui? Sur quelle donnée? Pour quelle opération? Sous quelle autorité?
Lorsque la réponse change, l’accès ou l’action autorisée devrait pouvoir changer avec elle.
Vous n’avez pas besoin de rendre toutes vos données « IA-ready »
Il existe également un piège inverse : croire qu’il faut nettoyer, centraliser et reconstruire toute l’architecture de données avant de pouvoir commencer.
Ce n’est pas nécessairement le cas.
Un processus précis peut être un meilleur point de départ.
Prenez une demande de service. Identifiez les cinq ou six informations réellement nécessaires pour la traiter. Déterminez où elles se trouvent. Vérifiez lesquelles l’agent peut consulter. Définissez les droits. Clarifiez les actions possibles et celles qui nécessitent une approbation.
Puis répétez avec le processus suivant.
Cette approche évite de transformer « préparer nos données pour l’IA » en programme de transformation de cinq ans dont personne ne se rappelle exactement pourquoi il a commencé.
La vraie question n’est plus « avons-nous les données? »
Pendant longtemps, la préparation à l’IA a été présentée comme une question de volume ou de qualité de données.
Avec les agents, cette définition devient insuffisante.
Une entreprise peut posséder d’excellentes données et néanmoins être mal préparée si elle ne peut pas déterminer qui peut les utiliser, dans quel contexte et avec quelle autorité.
La question pour la direction devient donc :
« Pouvons-nous donner à un agent exactement les informations dont il a besoin pour accomplir une tâche précise — sans lui donner accès ou autorité au-delà de cette tâche? »
C’est une question de données.
Mais c’est aussi une question d’identité, de permissions, de processus et de gouvernance.
Et lorsque l’IA commence à agir, ces sujets ne peuvent plus être traités séparément.